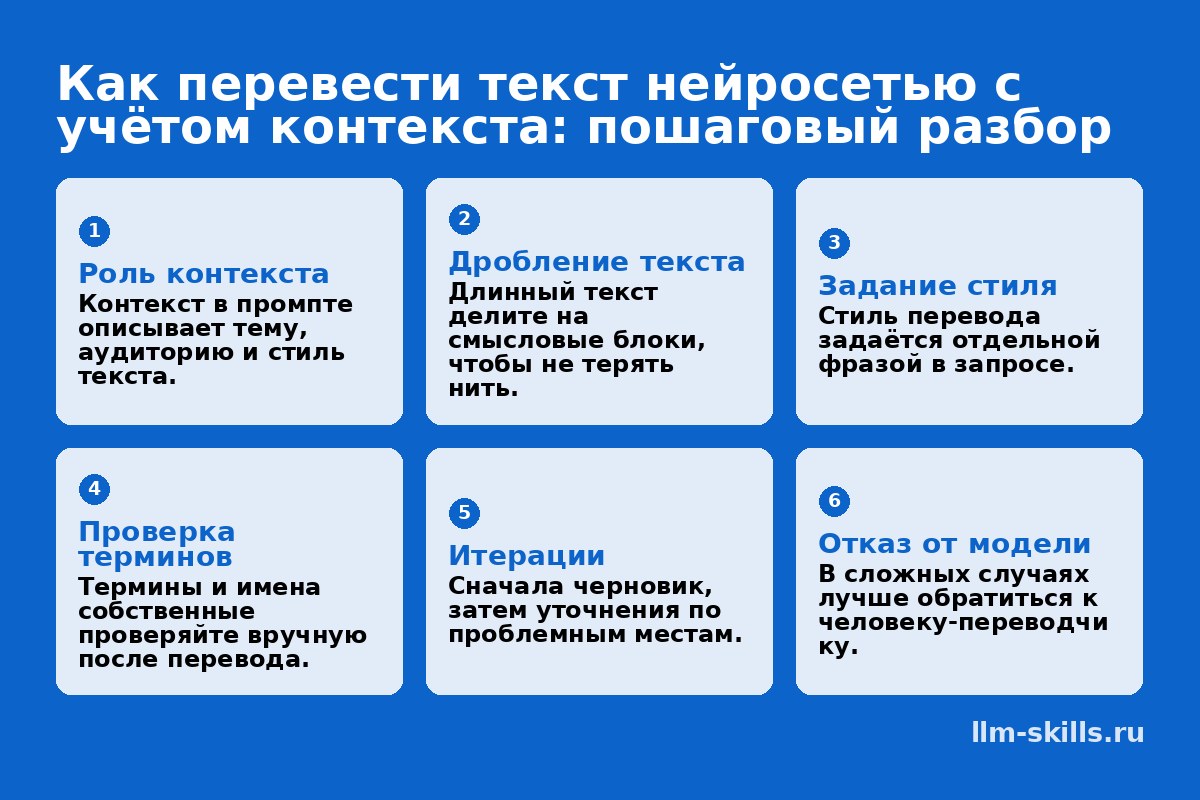
Нейросеть переводит заметно лучше, если в запросе явно описать, о чём текст, для кого он и в каком стиле должен звучать. Достаточно добавить несколько уточнений к промпту — и результат перестаёт быть дословным и становится пригодным к публикации.
Почему дословный запрос «переведи текст» даёт слабый результат
Короткая команда «переведи текст» оставляет модели слишком много свободы. Без указания темы, аудитории и стиля она опирается на статистику: выбирает самое частотное значение слова, а не то, которое нужно в этом предложении. В результате получается грамматически верный, но безликий текст, где термины переведены «в среднем», идиомы разобраны буквально, а интонация оригинала исчезла.
Особенно заметно это на многозначной лексике. Английское bank без контекста может стать и «банком», и «берегом», а commitment — то «обязательством», то «приверженностью». Модель не ошибается в языке, она просто не знает, о чём именно идёт речь, и подставляет наиболее вероятный вариант. То же происходит со стилем: деловое письмо и художественный фрагмент получают одинаково нейтральную окраску, а обращение на «вы» или «ты» выбирается случайно.
Ещё одна потеря — связность. Фразы переводятся по отдельности, и местоимения, союзы, повторы начинают указывать не туда, куда указывали в оригинале. Читатель видит набор правильных предложений, которые плохо стыкуются между собой.
Чем меньше в запросе сведений о тексте, тем больше модель угадывает — и тем дальше результат от того, что нужно заказчику.
Что входит в контекст перевода: пять параметров для промпта
Качество машинного перевода зависит от того, насколько полно в запросе описана ситуация использования текста. Пять параметров закрывают почти все случаи: тема, аудитория, стиль, назначение и терминологические ограничения.
Тема и предметная область
Укажите, о чём идёт речь и к какой сфере относится материал. Модель по-разному передаёт юридические формулировки, медицинские описания и маркетинговые тексты — предметная область задаёт словарь и снимает часть двусмысленностей ещё до перевода.
Аудитория и уровень подготовки
Читатель определяет, насколько подробно нужно разворачивать термины и можно ли оставлять профессиональный жаргон. Текст для специалистов и текст для новичков на одну и ту же тему переводятся по-разному.
Стиль и назначение текста
Стиль отвечает за регистр и синтаксис, назначение — за то, как текст будет использоваться дальше. Параметр «назначение» полезно проговорить отдельно: публикация, внутренняя инструкция и письмо клиенту требуют разной степени формальности.
Пятый параметр — ограничения по терминам. Их удобно свести в таблицу, чтобы не забыть при составлении запроса.
| Параметр | Что указать | На что влияет |
|---|---|---|
| Тема | Сфера и предмет текста | Подбор словаря |
| Аудитория | Кто будет читать | Степень детализации |
| Стиль | Формальный, нейтральный, разговорный | Регистр и синтаксис |
| Назначение | Публикация, инструкция, письмо | Формат подачи |
| Термины | Что оставить как есть | Единообразие лексики |
Проверить запрос перед отправкой можно по короткому списку:
- названа ли сфера текста
- описан ли читатель
- задан ли стиль и цель
- перечислены ли термины, которые нельзя переводить.
Как перевести текст нейросетью: пошаговый порядок действий
Начинается работа не с промпта, а с самого исходника. Прочитайте текст целиком и отметьте фрагменты, которые без пояснений поймёт только носитель: идиомы, реалии, сокращения, отсылки к местным событиям. Эти места стоит отдельно прокомментировать в запросе.
Дальше выстройте порядок так:
- Разбейте материал на смысловые блоки — абзац или небольшую группу абзацев, чтобы нейросеть не теряла нить.
- Для каждого блока сформулируйте запрос с описанием темы, аудитории и нужного стиля.
- Отправьте фрагмент и сразу сверьте результат с оригиналом на предмет пропусков и добавленных смыслов.
- Проверьте терминологию и имена собственные: единообразие важнее красивых формулировок.
- Соберите перевод в единый файл и прочитайте его подряд, без опоры на исходник, — так видны шероховатости стиля.
- Внесите правки и при необходимости верните проблемный абзац в работу с уточнённым запросом.
Финальная вычитка — это не только орфография. Оцените, звучит ли текст естественно для читателя и сохранилась ли логика между блоками после раздельной обработки.
Примеры промптов: от короткого к подробному
Возьмём один и тот же фрагмент — абзац из инструкции к прибору — и посмотрим, как меняется перевод при разной степени детализации запроса. Сначала минимальный вариант:
Переведи на английский:
«Перед первым включением дайте устройству прогреться до комнатной температуры.»
Модель выдаст грамматически вертную фразу, но выберет слова наугад: «прогреться» может превратиться в heat up, а «дать» — в give, что звучит как команда человеку, а не как условие эксплуатации. Смысл угадывается, тон — нет.
Теперь тот же фрагмент с описанием ситуации:
Переведи на английский абзац из руководства пользователя
бытового прибора. Аудитория — покупатели без технического
образования. Стиль — нейтральный, инструктивный, без
разговорных оборотов. Сохрани структуру предложения.
«Перед первым включением дайте устройству прогреться
до комнатной температуры.»
Результат меняется заметно: глагол «дайте» уходит, появляется конструкция с allow или let, а «прогреться» передаётся через reach room temperature — так пишут в документации. Модель уже не переводит слово в слово, а подбирает формулировку под жанр.
Максимальная детализация добавляет ограничения на термины и запреты:
Тот же абзац. Не используй give и warm up.
Термин «устройство» переводи как device, а не unit.
Предложение должно начинаться с условия (Before...).
Чем конкретнее запрос, тем меньше правок после него. Но детализация работает только тогда, когда вы сами понимаете, для кого и зачем этот текст.
Как задавать стиль перевода и не потерять его при правках
Требования к стилю работают, когда они конкретны и проверяемы. Формулировка «переведи красиво» ничего не сообщает модели, а «деловой тон, без канцелярита, обращения на „вы“» задаёт рамку, которую можно соблюсти или нарушить. Полезно сразу назвать жанр, аудиторию и то, чего в тексте быть не должно.
Формулировки для официального и разговорного стиля
Для официального регистра указывайте тип документа, степень формальности и допустимую лексику. Для разговорного — наоборот, разрешайте сокращения, живые обороты и короткие фразы, иначе модель незаметно вернётся к нейтральному книжному слогу.
- Официальный: «язык договора, нейтральная лексика, без эмоциональных оценок, термины — единообразно».
- Разговорный: «как в переписке с коллегой, короткие предложения, допустимы разговорные связки».
- Запреты: перечислите, чего избегать — штампов, пассивных конструкций, англицизмов.
- Ориентир: приложите короткий фрагмент-образец, если он есть.
Что делать, если стиль «съезжает» при уточнениях
Каждая новая правка рискует сдвинуть тон: модель переписывает фразу и заодно меняет регистр. Поэтому стилевые требования держите в постоянной части запроса и повторяйте их при каждом уточнении, а не только в первом сообщении. Правьте точечно — по одному фрагменту, — и после каждой итерации сверяйте результат с исходной формулировкой стиля.
Если тон всё равно уплывает, вернитесь к последней удачной версии и опишите расхождение прямо: «здесь появился канцелярит, верни прежнюю разговорную интонацию». Стабильность стиля держится на повторяемых требованиях, а не на разовых уточнениях.
Длинные тексты и документы: как не потерять контекст между фрагментами
Большой документ почти никогда не помещается в одно обращение к модели целиком — либо не хватает лимита, либо качество падает к концу. Рабочий приём — резать текст на смысловые блоки: по разделам, главам или абзацам, а не по формальному числу символов. Границы лучше проводить там, где заканчивается мысль, иначе переводчик теряет подлежащее и сказуемое на стыке.
Чтобы фрагменты не расползались по тону и терминам, к каждому следующему запросу добавляют краткое резюме предыдущей части. Достаточно двух-трёх предложений: о чём шла речь, какие термины уже выбраны, в каком лице и времени ведётся повествование. Модель опирается на это как на память и не начинает каждый блок с чистого листа.
- Резюме предыдущего блока — смысл, ключевые имена и решения по терминам.
- Единый глоссарий — список терминов с закреплённым переводом, который передаётся в каждом запросе.
- Фиксированные правила стиля — обращение, время, оформление чисел и названий.
- Порядок сборки — переводить блоки последовательно, а не параллельно, чтобы резюме было настоящим.
Глоссарий удобно вести отдельным файлом и дополнять по ходу: если в третьем блоке появился новый термин, он попадает в список и дальше используется без колебаний. Стилевые правила достаточно сформулировать один раз и вставлять в начало каждого запроса.
После сборки стоит перечитать стыки блоков — именно там чаще всего видны разъехавшиеся формулировки. Небольшая сверка на переходах дешевле, чем повторный перевод всего документа.
Типичные ошибки при переводе нейросетью и как их заметить
Проверять результат стоит по формальным признакам, а не по общему впечатлению «звучит гладко». Нейросеть уверенно переписывает фразу, но при этом может незаметно исказить деталь, от которой зависит смысл документа.
- Термины: одно понятие в исходнике должно переводиться одинаково по всему тексту, а не тремя синонимами.
- Имена и названия: сверьте написание компаний, людей и продуктов с оригиналом.
- Числа и единицы: проверьте разряды, даты, валюты и перевод единиц измерения в привычную систему.
- Ложные друзья переводчика: слова, похожие на русские, но означающие иное, — частая причина смысловых сдвигов.
- Выпавшие фрагменты: сравните число абзацев и предложений в оригинале и переводе.
Для быстрой сверки удобно вести таблицу по фрагментам: так видно, где именно возникло расхождение, и не приходится перечитывать весь текст заново.
| Что проверяем | Признак ошибки | Как исправить |
|---|---|---|
| Терминология | Разные слова для одного понятия | Задать глоссарий в промпте |
| Числа и даты | Сдвиг разрядов, смена формата | Сверить с оригиналом вручную |
| Единицы измерения | Метрика заменена без пересчёта | Указать систему в запросе |
| Полнота | Пропал абзац или строка списка | Перевести фрагмент повторно |
Такой чек-лист занимает несколько минут, но отсекает большинство ошибок, которые читатель заметит раньше вас.
Когда стоит отказаться от нейросети и обратиться к человеку-переводчику
Есть категории текстов, где даже аккуратно составленный промпт не снимает рисков. Речь о случаях, когда ошибка перевода имеет последствия: деньги, репутация, здоровье, юридический статус. Здесь нейросеть уместна как черновик или подспорье, но финальное решение должен принимать человек.
Отдельно стоит сказать о документах, по которым возникают обязательства: договоры, доверенности, официальные заявления, инструкции по применению. Формулировки в них связаны между собой, а неточность меняет смысл обязательства. Нейросеть не несёт ответственности за результат, поэтому проверка профессиональным переводчиком или юристом здесь не формальность.
Художественные тексты — другая граница. В них важны ритм, игра слов, культурные отсылки и авторский голос. Модель передаёт общий смысл, но часто сглаживает стиль и теряет подтекст, который и составляет ценность произведения.
Отказаться от автоматического перевода стоит, если:
- текст влечёт юридические или финансовые последствия
- это литература, поэзия, сценарии, где значим авторский стиль
- перевод пойдёт в публикацию или к клиенту без вычитки
- в тексте есть термины узкой области, где нужна проверка специалиста
- цена ошибки выше стоимости работы переводчика.
В остальных случаях разумный подход — использовать нейросеть для черновика, а к человеку обращаться точечно: на вычитку и на самые чувствительные фрагменты.
Частые вопросы
Нужно ли указывать в запросе тему текста, если она и так понятна из самого текста?
Да, стоит. Модель видит фрагмент целиком, но без явного указания может выбрать неверное значение многозначного слова. Одна фраза о теме снижает число таких ошибок.
Можно ли перевести весь документ одним запросом?
Технически можно, но на длинных текстах модель чаще сокращает фрагменты и теряет единообразие терминов. Надёжнее делить текст на смысловые блоки и вести глоссарий.
Как заставить нейросеть переводить в официально-деловом стиле?
Укажите это прямо в промпте и добавьте назначение текста, например «для договора» или «для внутренней инструкции». Помогает также привести один пример формулировки нужного стиля.
Почему нейросеть иногда меняет имена и названия компаний?
Модель может принять имя собственное за обычное слово или подобрать похожее по смыслу. Перед переводом перечислите имена и названия отдельным списком с пометкой «не переводить».
Стоит ли просить модель сразу дать несколько вариантов перевода?
Да, это удобно для коротких фрагментов: вы увидите разные трактовки и выберете подходящую. Для длинных текстов лучше сначала зафиксировать стиль на одном абзаце.
Как проверить, что перевод не потерял смысл?
Сравните количество абзацев и ключевых утверждений в оригинале и переводе. Отдельно сверьте числа, единицы измерения, отрицания и термины — именно там чаще всего возникают расхождения.