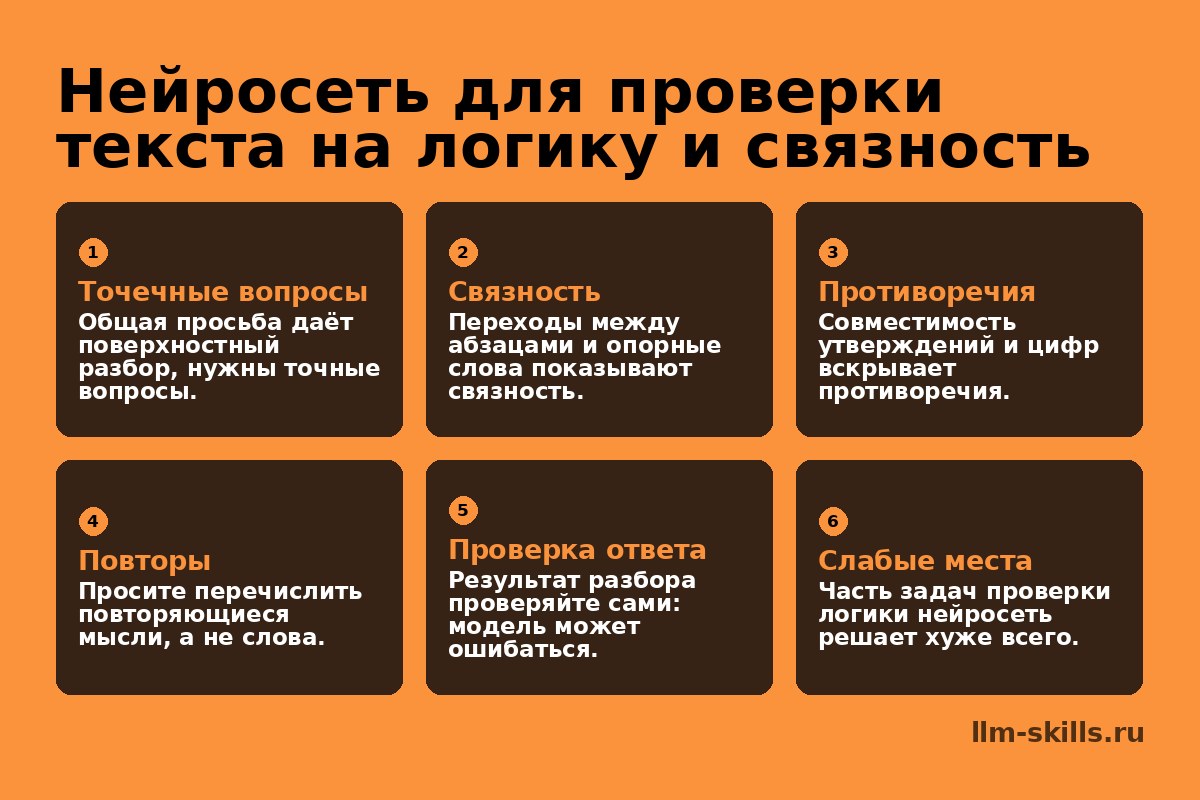
Нейросеть может проверить не только орфографию, но и логику: найти разрывы между абзацами, противоречия в утверждениях и повторы. Чтобы получить полезный разбор, задавайте модели конкретные вопросы по чек-листу, а не общую просьбу «проверь текст».
Что именно проверяет нейросеть, кроме орфографии
Модель полезна там, где формально всё верно, но текст «не держится»: мысль прыгает, аргумент обрывается, вывод не вытекает из посылок. При этом она не заменяет корректора — орфографию и пунктуацию надёжнее проверять специализированными инструментами, а нейросеть подключают для смыслового уровня. Ниже — категории проблем, которые она способна заметить при аккуратно поставленном запросе.
Смысловые разрывы между абзацами
Модель отслеживает, как связаны соседние фрагменты: есть ли переход от одной мысли к другой, не пропущено ли звено рассуждения. Часто она указывает на абзац, который начинается с новой темы без подготовки, или на место, где вывод появляется раньше аргументов. Полезно и то, что нейросеть замечает «висящие» отсылки — упоминания, которые в тексте не раскрыты.
Противоречия в утверждениях и цифрах
Если в одном месте сказано одно, а в другом — обратное, модель это подсветит. Она сверяет формулировки между разделами и обращает внимание на несовпадающие числа, сроки, условия. Речь не о том, что нейросеть сама знает правильные данные: она показывает несоответствия внутри вашего текста, а проверять их достоверность всё равно автору.
Повторы мыслей и формулировок
Одна и та же идея нередко возвращается в разных абзацах под другими словами — глаз автора к этому привыкает. Модель перечисляет такие места и помогает решить, что оставить, а что убрать или объединить. Сюда же относятся тавтологии на уровне смысла: когда пример повторяет тезис, ничего к нему не добавляя.
Категории, с которыми модель справляется хуже, стоит держать в голове заранее:
- фактическая точность утверждений и корректность источников
- логика внутри очень длинных и запутанных рассуждений
- соответствие текста узкой предметной терминологии
- стилистическая уместность для конкретной аудитории.
Эти границы важны: нейросеть помогает увидеть смысловые проблемы, но итоговое решение о правках остаётся за человеком.
Как подготовить текст и запрос, чтобы разбор был полезным
Перед обращением к модели текст стоит привести в вид, удобный для анализа: длинные фрагменты она просматривает хуже, чем короткие. Разбейте материал на смысловые блоки по 1–3 абзаца и подавайте их по очереди. Так модель удерживает контекст и реже теряет связь между утверждениями, разнесёнными далеко друг от друга.
Затем задайте модели роль — это заметно меняет качество разбора. Формулировка «ты редактор, который проверяет логику и связность» работает лучше, чем нейтральная просьба оценить текст. Роль задаёт критерии: редактор смотрит на переходы между абзацами и на противоречия, а не на стилистические мелочи.
Формат ответа пропишите заранее, иначе разбор придёт сплошным потоком замечаний. Удобно просить список пунктов с указанием фрагмента и кратким объяснением проблемы. Если нужен разбор по приоритетам, скажите об этом прямо: сначала смысловые разрывы, потом повторы, потом всё остальное.
Порядок подготовки выглядит так:
- Разделите текст на логические блоки и пронумеруйте их, чтобы ссылаться на конкретные части.
- Сформулируйте роль модели и укажите, что именно она оценивает.
- Задайте формат ответа: структура пунктов, длина пояснений, порядок замечаний.
- Добавьте ограничение по объёму — просите не больше нескольких замечаний на блок.
- Отправляйте блоки по отдельности, а не весь материал сразу.
Отдельно оговорите, что модель не должна переписывать текст, если вам нужен только разбор. Иначе вместо замечаний придёт готовая редактура, и вы потеряете исходные формулировки. Чёткое техническое задание на разбор экономит время больше, чем любая дополнительная итерация.
Чек-лист вопросов к нейросети о логике текста
Проверку стоит разбить на три блока вопросов — так модель не распыляется и отвечает по делу. Формулировки ниже можно копировать в чат почти без изменений, подставляя свой текст.
Проверка переходов и связности
Сначала выясняйте, держится ли текст как единое целое. Попросите модель пройти по стыкам абзацев и назвать места, где мысль перескакивает.
- Покажи, где заканчивается одна мысль и начинается следующая. Есть ли между ними логический мостик?
- Какие абзацы можно переставить без потери смысла, а какие держатся только на своём месте?
- Найди предложения, которые не связаны с предыдущим и следующим. Объясни, почему связь потеряна.
- Какие слова-связки («поэтому», «однако», «кроме того») стоят не на месте или противоречат смыслу соседних фраз?
Поиск противоречий и нестыковок
Дальше просите сверить утверждения между собой. Модель хорошо ловит пары фраз, где одна отрицает другую, если указать ей искать именно это.
- Найди два утверждения, которые не могут быть верны одновременно. Процитируй оба.
- Есть ли в тексте места, где вывод не следует из приведённых ранее фактов?
- Проверь, одинаково ли используются ключевые понятия во всех абзацах, или значение незаметно меняется.
- Укажи повторы одной и той же мысли разными словами.
Оценка аргументации и выводов
Последний блок — про качество доказательств. Спрашивайте не «убедительно ли», а что именно подкрепляет тезис.
- Перечисли тезисы текста и для каждого — аргументы, которые его поддерживают. Где аргументов нет?
- Какие утверждения поданы как факт, но ничем не подтверждены?
- Соответствует ли финальный вывод тому, что доказывалось в основной части?
Разбор по конкретным вопросам даёт проверяемые замечания, а общая просьба — лишь пересказ текста своими словами.
Как читать ответ нейросети и не принимать его на веру
Модель отвечает уверенным тоном даже там, где ошибается, поэтому разбор стоит воспринимать как черновик редактора, а не как приговор. Часть замечаний окажется ложной, часть реальных проблем останется незамеченной, а формулировки — расплывчатыми. Отличать одно от другого помогает привычка проверять каждое замечание по исходному тексту.
Типичные сбои в ответах
Ложные срабатывания — модель находит противоречие или разрыв там, где его нет. Часто это происходит с местоимениями, терминами в разных формах и сжатыми переходами, которые автор считает очевидными. Проверка простая: откройте указанное место и посмотрите, действительно ли читатель теряет связь.
Пропуски — модель молчит о реальной дыре в аргументации, потому что та не выражена явно. Особенно часто пропускаются неявные посылки: вывод звучит гладко, но опирается на утверждение, которого в тексте нет. Пропуски опаснее ложных срабатываний, поскольку создают ощущение, что текст проверен полностью.
Общие замечания вроде «абзац недостаточно связный» или «аргументация слабая» бесполезны: непонятно, что именно править. Такие формулировки стоит отбрасывать или переспрашивать, требуя указать конкретное предложение и причину.
Критерии отбора замечаний
| Тип замечания | Признак | Что делать |
|---|---|---|
| Ложное срабатывание | Смысл на месте, связь восстанавливается | Отклонить |
| Реальный разрыв | Нужно дочитать дальше, чтобы понять переход | Переписать стык |
| Противоречие | Два утверждения несовместимы | Уточнить или снять одно |
| Общая претензия | Нет указания на место и причину | Переспросить |
| Повтор | Одна мысль изложена дважды разными словами | Сократить |
Отбирайте только те замечания, которые можно привязать к конкретному фрагменту и объяснить своими словами. Если формулировку модели не удаётся пересказать без потери смысла, скорее всего, за ней ничего не стоит.
Пример разбора: что модель может найти в абзаце
Возьмём условный фрагмент из трёх абзацев: в первом говорится, что команда перешла на новую систему отчётности, во втором описаны сложности с обучением сотрудников, а в третьем утверждается, что переход прошёл без потерь и обучение никому не потребовалось. Модель, получившая такой текст с просьбой проверить последовательность, укажет на противоречие между вторым и третьим абзацами: если обучение описано как проблемное, вывод об отсутствии необходимости в нём не вытекает из предыдущего.
Отдельно фиксируются разрывы. Например, между абзацем о причинах задержек и абзацем о росте показателей нет связующего звена — читателю непонятно, за счёт чего произошло улучшение. Модель отметит, что связь подразумевается, но не выражена, и предложит добавить переходное предложение или уточнить причину.
Повторы выглядят иначе: одна и та же мысль возвращается в разных формулировках, и абзац перестаёт двигать рассуждение вперёд. Модель может показать два соседних предложения, где сказано об одном и том же, и предложить объединить их или убрать лишнее.
Чтобы замечания были конкретными, в запросе стоит ограничить задачу и попросить ссылаться на фрагменты.
Проверь фрагмент на связность и логику.
1. Найди места, где между абзацами пропущено связующее звено.
2. Укажи противоречащие друг другу утверждения.
3. Отметь повторы мыслей.
Для каждого замечания приведи начало и конец предложения
и объясни в одном предложении, что не так.
Ответ на такой запрос обычно принимает вид списка: фрагмент — характер проблемы — короткое пояснение. Такой формат удобно сверять с собственным замыслом, потому что видно, к какому именно месту относится замечание и на чём оно основано.
Какие задачи проверки логики нейросеть решает хуже всего
Хуже всего модель справляется с текстами, которые не помещаются в её контекст целиком. Если статья или отчёт длиннее нескольких десятков тысяч знаков, нейросеть видит фрагменты, но теряет общую нить: утверждение из первого раздела и оговорка в последнем для неё уже не связаны. В итоге противоречие между ними остаётся незамеченным, хотя формально каждый кусок выглядит логично.
Второй слабое место — узкоспециальная лексика. Когда в тексте много отраслевых терминов, аббревиатур и внутренних обозначений, модель может неверно истолковать смысл фразы и «найти» несуществующую нестыковку. Особенно это заметно в юридических, медицинских и инженерных документах, где значение слова зависит от контекста и нормативных актов.
Отдельная категория — скрытые противоречия в данных. Нейросеть хорошо ловит явные несовпадения («рост выручки» и «падение выручки» в соседних абзацах), но плохо замечает несоответствия, разнесённые по тексту или спрятанные в цифрах. Например, сумма долей в таблице не равна ста процентам, а вывод опирается на устаревшие показатели — такое модель пропустит, если не указать на это прямо.
Что даётся тяжелее всего:
- длинные документы, где логика держится на связях между удалёнными частями
- термины и сокращения, понятные только внутри организации или отрасли
- противоречия, выраженные числами, датами и единицами измерения
- тексты с намеренной недосказанностью, где вывод подразумевается, а не формулируется
- материалы с большим числом оговорок и исключений, которые меняют смысл основного тезиса.
Практический вывод простой: чем короче фрагмент и чем яснее в нём расставлены смысловые опоры, тем надёжнее разбор. Длинный материал лучше дробить на части и проверять их по отдельности, а затем отдельно задавать вопросы о связях между частями.
Частые вопросы
Можно ли проверить логику текста бесплатной нейросетью?
Да, базовые модели справляются с поиском повторов и разрывов на коротких фрагментах. Для больших текстов лучше разбивать материал на части и проверять их по очереди.
Нейросеть найдёт все противоречия в тексте?
Нет, модель может пропустить неявные противоречия или придумать несуществующие. Её ответ — это список гипотез, которые нужно проверить по исходному тексту.
Какой длины текст давать нейросети для анализа связности?
Оптимально — один-два абзаца или небольшой раздел. В длинном тексте модель теряет контекст и начинает давать общие замечания.
Чем проверка логики отличается от редактуры?
Редактура исправляет стиль, грамматику и точность формулировок. Проверка логики ищет смысловые разрывы, противоречия и повторы мыслей, а не ошибки в словах.
Можно ли использовать нейросеть для проверки текста на связность в научной работе?
Да, но с осторожностью: модель может не знать терминологии и предложить ложные правки. Используйте её как вспомогательный инструмент, а не как единственного критика.