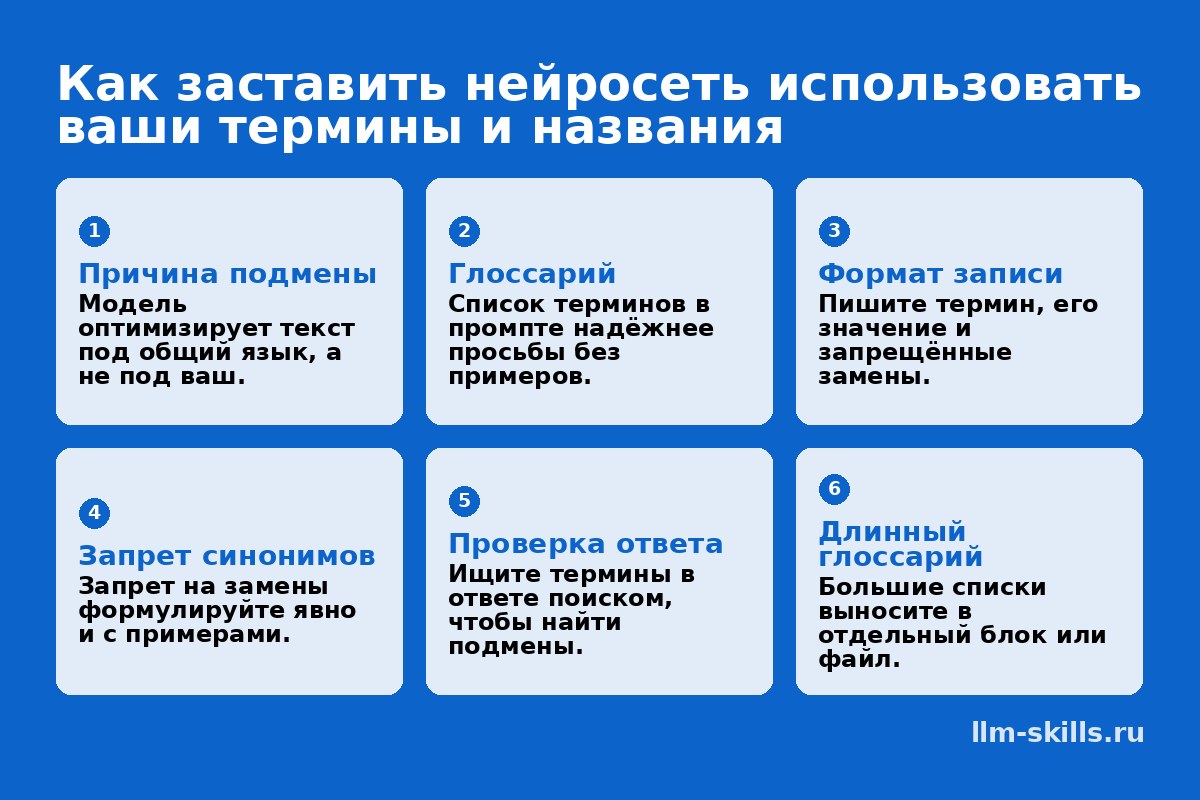
Чтобы нейросеть не переименовывала ваши сущности, дайте ей явный глоссарий в промпте и отдельным пунктом запретите синонимы и перевод. Работает связка: список терминов в формате «как писать — что это — чего нельзя» плюс правило проверки ответа перед выдачей.
Почему нейросеть переименовывает ваши сущности
Модель не знает, что «Клиент» в вашем документе — это конкретная сущность с идентификатором, а «клиент» в общем тексте — просто слово. Она видит последовательность токенов и предсказывает следующее слово по вероятности, обученной на огромном корпусе общих текстов. В этом корпусе рядом со словом «клиент» чаще стоят «пользователь», «заказчик», «покупатель» — и модель тянется к ним.
Отсюда и подмена: нейросеть не «решает» переименовать, она приводит текст к тому, как обычно пишут в её обучающих данных. Ваши внутренние названия для неё — просто редкие слова, которые статистически выгоднее заменить на частотные синонимы. Особенно если термин выглядит как калька, аббревиатура или необычное словосочетание.
Срабатывают несколько механизмов:
- Сглаживание формулировок. Модель считает «нормальным» общепринятый вариант и подставляет его вместо вашего.
- Перевод и транслитерация. Английский термин в промпте легко превращается в русский аналог, даже если вы просили оставить оригинал.
- Обобщение. Узкое название заменяется родовым понятием: «Спринт 4» становится «четвёртым этапом».
- Достраивание контекста. Если термин встретился один раз, модель не считает его обязательным и переходит на привычную лексику.
Причина одна: у модели нет вашего внутреннего словаря как приоритета. Пока он не задан явно и не подкреплён запретом, общеязыковая статистика побеждает.
Что такое глоссарий для нейросети и как он выглядит
Минимальный формат из трёх колонок
Глоссарий для нейросети — это компактный список сущностей проекта, где у каждой есть каноническое написание, краткое определение и перечень замен, которые нужно отклонить. Три колонки закрывают главный риск: модель понимает, о чём речь, и одновременно видит границы допустимых формулировок.
Определение пишите в одно предложение — этого достаточно, чтобы модель уловила смысл и не начала додумывать. В колонке запретов перечисляйте синонимы, переводы и сокращения, которые встречались в ваших текстах или типичны для темы.
| Как писать | Что это | Чего нельзя |
|---|---|---|
| Каскад | Модуль согласования заявок | cascade, цепочка, воронка |
| Оператор | Сотрудник, ведущий заявку | менеджер, агент, куратор |
| Пульс | Еженедельный отчёт по нагрузке | pulse, дашборд, сводка |
Пример глоссария для вымышленной компании
Шаблон ниже можно скопировать и заменить строки своими сущностями. Формулировка запрета идёт отдельным блоком, чтобы модель не путала её с описанием.
ГЛОССАРИЙ (использовать только эти написания):
1. Каскад — модуль согласования заявок. Не писать: cascade, цепочка, воронка.
2. Оператор — сотрудник, ведущий заявку. Не писать: менеджер, агент, куратор.
3. Пульс — еженедельный отчёт по нагрузке. Не писать: pulse, дашборд, сводка.

ПРАВИЛО: если сущности нет в списке — оставить авторское написание.
Синонимы, переводы и сокращения из колонки «нельзя» не использовать.
Держите таблицу и блок в промпте в одном виде: расхождение между ними модель воспримет как разные сущности.
Как встроить глоссарий в промпт: пошаговый порядок
Глоссарий работает только тогда, когда стоит в промпте на своём месте, а не свален в конец вместе с прочими пожеланиями. Порядок действий ниже выстроен так, чтобы модель сначала усвоила правила, а уже потом взялась за текст.
- Откройте промпт с описанием задачи. Вставьте глоссарий сразу после инструкции о том, что нужно сделать, но до самого задания и исходных материалов. Модель прочитает ограничения раньше, чем начнёт писать.
- Отделите глоссарий явным заголовком. Достаточно строки вроде «Термины проекта» или «Названия использовать строго так». Без заголовка список сливается с остальным текстом и теряет вес.
- Добавьте правило применения. Одной фразой укажите, что перечисленные названия нельзя склонять по-своему, сокращать, переводить и заменять синонимами. Правило ставится после списка, чтобы относилось именно к нему.
- Поставьте задачу следом. Только теперь идёт текст запроса и данные. Такая очерёдность снижает шанс, что модель придумает обозначение по ходу генерации.
- Проверьте ответ на подмену. Пройдитесь по готовому тексту и сверьте каждое название с глоссарием. Если модель отклонилась, верните ей ответ с пометкой, какое слово заменено, и попросите переписать.
Если правок много, не переписывайте промпт целиком — усиливайте формулировку запрета и повторяйте проверку. Устойчивый результат появляется после двух-трёх таких циклов, когда модель получает обратную связь по конкретным словам, а не общее замечание.
Формулировки запрета: какие фразы работают, а какие нет
Фраза «используй мои слова» почти не влияет на результат: модель воспринимает её как пожелание к стилю, а не как ограничение. Она по-прежнему считает синоним допустимым, если тот кажется ей точнее или привычнее. Запрет начинает работать, когда в нём назван сам механизм подмены — синонимы, перевод, сокращения — и указано, что делать вместо них.
Слабая формулировка описывает желание, сильная — действие и его границы. Сравните, как меняется смысл при добавлении конкретики.
| Формулировка | Что слышит модель | Результат |
|---|---|---|
| «Используй мои слова» | Пожелание к стилю | Подмена остаётся |
| «Старайся не переименовывать» | Мягкая рекомендация | Синоним проскочит |
| «Пиши термин так, как в списке, без синонимов» | Правило написания | Подмена реже |
| «Не заменяй термин синонимом, переводом или сокращением; если unsure — оставь исходное написание» | Запрет с перечнем | Подмена почти исчезает |
Работают формулировки с глаголом запрета и перечислением того, что именно нельзя: «не заменяй», «не переводи», «не сокращай», «не склоняй по-своему». Ещё полезно указать поведение в спорном случае — оставлять авторское написание, а не подбирать «более понятное».
Не работают общие слова без объекта: «будь точным», «соблюдай терминологию», «не искажай смысл». Они не сообщают, где именно проходит граница между допустимым и запрещённым, поэтому модель трактует их по своему усмотрению.
Чек-лист: проверяем ответ на подмену терминов
Готовый текст проверяют до публикации, а не после жалобы читателя на «странное» название. Проверка занимает пару минут, если идти по одним и тем же пунктам каждый раз.
- Поиск по каждому термину из глоссария. Прогоните ответ через поиск по списку: если сущность встречается в тексте, но не в той форме, что в глоссарии, — это подмена. Отдельно ищите случаи, когда термин пропал совсем: модель могла заменить его описанием.
- Сверка с исходным списком. Сравните написание один в один: латиница против кириллицы, дефис против пробела, заглавная буква внутри названия. Глаз пропускает такие мелочи, поэтому сверяйте механически, а не по памяти.
- Склонения и падежи. Проверьте, что окончания не искажают основу: неизменяемые названия не должны обрастать падежными формами, а аббревиатуры — расшифровываться заново. Если термин не склоняется по правилам языка, зафиксируйте это в глоссарии заранее.
- Регистр и капитализация. Убедитесь, что строчные и заглавные буквы расставлены так же, как в эталоне. Модель любит «выравнивать» регистр по соседним словам, особенно в заголовках и подписях.
- Синонимы рядом с термином. Просмотрите абзацы, где упоминается сущность: не появилось ли пояснение через другое слово. Даже удачная замена ломает единство текста, если термин должен звучать одинаково во всех разделах.
- Единообразие по всему ответу. Одна и та же сущность не должна называться по-разному в начале и в конце. Пролистайте текст целиком, а не только первые абзацы, где модель обычно держит форму.
Если хоть один пункт не прошёл, ответ возвращают на доработку с указанием конкретного места, а не переписывают целиком. Так модель быстрее понимает, что именно нарушено, и следующая версия выходит чище.
Что делать, если глоссарий длинный или их несколько
Когда сущностей десятки, держать весь перечень в одном сообщении неудобно: он съедает контекст и повышает шанс, что модель потеряет часть пунктов. Рабочий приём — вынести термины в отдельный файл и подгружать его по мере надобности. Если такой возможности нет, помогает деление на тематические блоки: названия продуктов, внутренние сокращения, имена ролей и статусов.
Один файл на все задачи или отдельные блоки
Единый файл удобен, когда термины пересекаются между задачами и важно, чтобы написание совпадало везде. Отдельные блоки лучше работают при слабо связанных направлениях: в промпт попадает только нужная часть, остальное не отвлекает модель.
- Общие сущности (компания, продуктовая линейка) — в базовый блок, он подключается всегда.
- Узкие темы (конкретный отдел, релиз, клиентский сегмент) — в отдельные блоки по задачам.
- Редкие термины — в архив, подключаемый точечно, чтобы не раздувать основной список.
Дробите по смыслу, а не по количеству: блок из пяти связанных терминов полезнее, чем три блока по два случайных.
Как ссылаться на глоссарий в диалоге
В самом промпте укажите, какой блок действует, и напомните, что написание берётся оттуда. При смене задачи явно сообщите о переходе на другой блок и перечислите, какие термины теперь в силе. Если ответ затрагивает сущность из неподключённого блока, попросите модель уточнить, а не угадывать.
Длинный список стоит периодически пересматривать: устаревшие названия удаляйте, иначе модель будет выбирать между старым и новым вариантом.
Типичные ошибки новичков при работе с терминами
Большинство проблем с подменой названий возникает не из-за слабости модели, а из-за того, как составлен промпт. Ошибки повторяются из раза в раз, и почти все они связаны с расположением глоссария и его оформлением.
- Глоссарий в конце промпта. Модель читает инструкции последовательно, и список терминов, приклеенный после длинного текста задачи, теряется среди прочих указаний. Правила лучше ставить до описания задачи, а не после.
- Нет примеров употребления. Перечисление «писать так, а не иначе» без образца фразы оставляет модели пространство для трактовки. Одно-два предложения с вашим термином в живом контексте снимают большую часть разночтений.
- Смешение языков. Если в глоссарии часть названий на русском, часть на английском, а задача описана третьим языком, модель начинает переводить и склонять термины по своему усмотрению. Держите единый язык для всех сущностей списка.
- Синонимы внутри самого промпта. Когда вы в постановке задачи называете сущность одним словом, а в глоссарии другим, модель выбирает то, что чаще встречается в тексте. Расхождений быть не должно ни в одном месте запроса.
- Слишком общий запрет. Формулировка «не используй другие слова» не привязана к конкретным сущностям и легко игнорируется. Запрет работает, когда перечисляет, какие именно замены недопустимы.
Отдельно стоит упомянуть привычку дописывать глоссарий в тот же блок, где задаётся тон и стиль ответа. Список терминов — это справочник, а не украшение инструкции, и ему нужно собственное место с явным заголовком.
Порядок и единообразие в промпте важнее длины глоссария: короткий список без противоречий соблюдается лучше, чем подробный, но разбросанный по тексту.
Частые вопросы
Почему нейросеть заменяет мои названия синонимами, хотя я их указал?
Скорее всего, глоссарий стоит в конце промпта или без примеров запрещённых замен. Модель видит термин, но не понимает, что его нельзя менять. Добавьте явный запрет и примеры.
Сколько терминов можно передать нейросети за один раз?
Зависит от модели и длины промпта. Начните с 10–20 ключевых терминов, остальные вынесите в отдельный блок или файл. Если ответы становятся хуже, сократите список до самых важных.
Нужно ли давать определение каждому термину?
Да, хотя бы короткое. Без определения модель может понять термин по-своему и подставить близкое по смыслу слово. Определение фиксирует значение.
Что делать, если нейросеть всё равно меняет термин в одном месте?
Укажите на конкретное место и попросите исправить по глоссарию. Если повторяется, добавьте этот случай в примеры запрещённых замен в промпте.
Можно ли запретить нейросети переводить термины на другой язык?
Да, добавьте отдельный пункт: «не переводить термины из глоссария, писать их в исходном написании». Это частый случай, когда модель считает термин иностранным и переводит его.
Подходит ли этот способ для любых нейросетей?
Подход общий: явный список терминов и запрет на замены. Конкретный синтаксис промпта может отличаться, но логика «список + правило + примеры» работает в большинстве чат-моделей.